Trong thế giới cloud-native, một cách tiếp cận rất phổ biến là chọn công cụ tốt nhất cho từng bài toán.
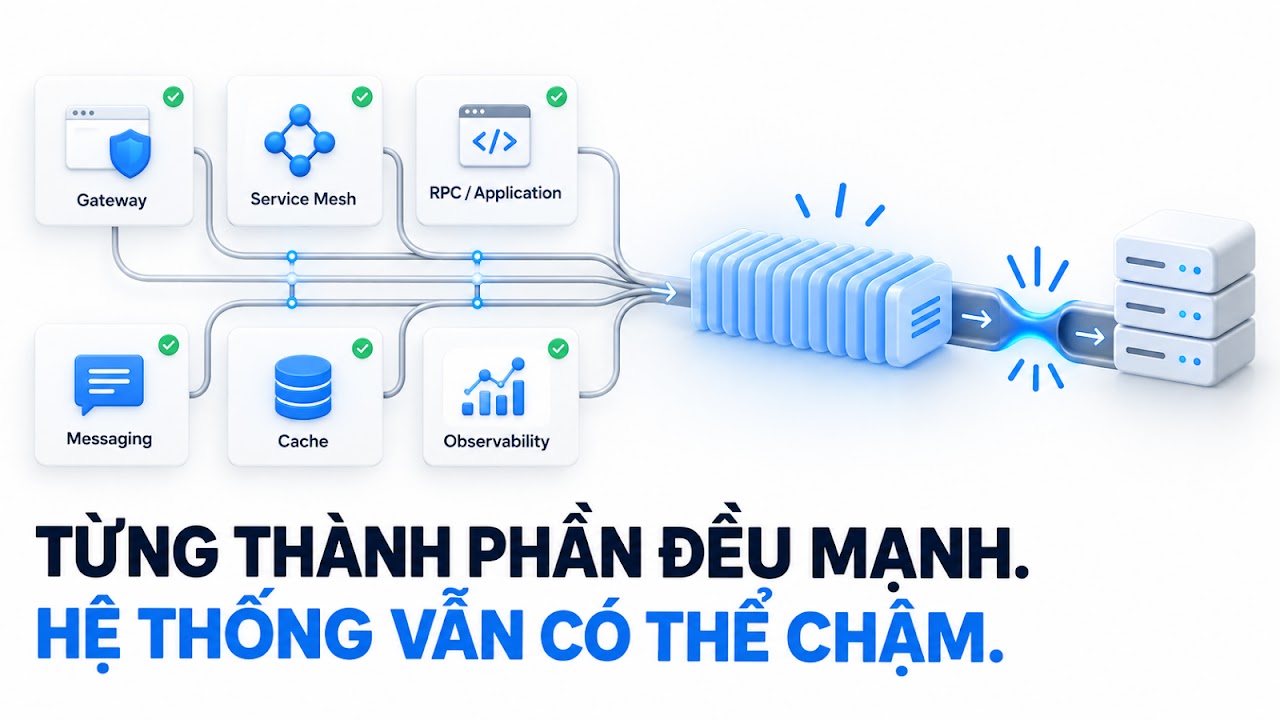
API Gateway dùng một sản phẩm mạnh. Giao tiếp giữa các dịch vụ dùng một service mesh trưởng thành. RPC dùng một framework có hiệu năng cao. Messaging dùng Kafka hoặc một message broker chuyên dụng. Cache dùng Redis. Quan sát hệ thống dùng OpenTelemetry, Prometheus và tracing. Khi tải tăng, Kubernetes tự động mở rộng.
Nhìn từng thành phần riêng lẻ, cách làm này rất hợp lý.
Mỗi công cụ đều được tối ưu rất sâu cho công việc của nó. Kafka có thể xử lý lượng message rất lớn. Envoy có hiệu năng proxy rất tốt. Redis cực nhanh trong nhiều loại workload. gRPC được tối ưu cho giao tiếp giữa các dịch vụ.
Nhưng khi ghép chúng thành một hệ thống, xuất hiện một vấn đề cơ bản:
Hiệu năng của hệ thống không phải là tổng hiệu năng của từng thành phần.
Người dùng không sử dụng Kafka, Envoy hay Redis riêng lẻ. Một yêu cầu của người dùng phải đi qua cả một chuỗi xử lý.
Thứ quyết định trải nghiệm cuối cùng là execution path — đường đi thực tế của một yêu cầu từ lúc được nhận cho đến khi hoàn thành.
Một component nhanh không làm cả hệ thống nhanh
Hãy hình dung một yêu cầu đi qua chuỗi:
Gateway → Service Networking → RPC → Application → Cache → Downstream Service
Mỗi thành phần có thể có benchmark rất đẹp.
Nhưng nếu một mắt xích trong chuỗi chỉ xử lý ổn định được 20.000 yêu cầu mỗi giây, việc các mắt xích phía trước xử lý được 100.000 hay 200.000 yêu cầu mỗi giây không làm hệ thống nhanh hơn.

Nó chỉ khiến hàng đợi phía trước điểm nghẽn tăng nhanh hơn.
Độ trễ cũng vậy.
Thời gian người dùng phải chờ không phải là độ trễ của một component riêng lẻ. Nó bao gồm thời gian xử lý ở nhiều nơi, thời gian truyền qua mạng, chuyển đổi dữ liệu, chờ hàng đợi, tranh chấp tài nguyên, gọi dịch vụ phụ thuộc, retry và timeout.
Đặc biệt, trong hệ thống phân tán, phần nguy hiểm thường không nằm ở thời gian xử lý trực tiếp mà nằm ở thời gian chờ.
Một service có thể vẫn chỉ dùng 40% CPU nhưng đã bắt đầu nghẽn vì connection pool đầy.
Một database vẫn hoạt động nhưng một nhóm query đang chậm.
Một message broker vẫn khỏe nhưng một partition cụ thể đã tích backlog.
Một downstream service vẫn chạy nhưng concurrency đã kín.
Khi đó, phần lớn dashboard có thể vẫn xanh trong khi người dùng đã cảm nhận hệ thống chậm đi rõ rệt.
The unit of performance is not the component. It is the execution path.
Đơn vị cần nhìn khi đánh giá hiệu năng không phải từng component, mà là toàn bộ đường thực thi.
Điểm yếu nhất quyết định hiệu năng của cả đường thực thi
Trong một hệ thống đơn giản, bottleneck — điểm nghẽn — thường dễ phát hiện.
Trong một hệ thống phân tán, bottleneck có thể thay đổi liên tục.
Lúc này nó nằm ở database.
Một lúc sau nó chuyển sang message broker.
Sau đó một downstream service hết khả năng xử lý đồng thời.
Tiếp theo connection pool đầy.
Rồi một dependency bên ngoài phản hồi chậm.
Autoscaler có thể nhìn thấy CPU tăng và tạo thêm instance, nhưng instance mới cần thời gian để khởi động. Trong thời gian đó, request vẫn tiếp tục đến và retry có thể khiến tải còn tăng mạnh hơn.
Vì vậy không tồn tại một “điểm yếu nhất” cố định.
Điểm nghẽn thay đổi theo trạng thái thực tế của hệ thống tại từng thời điểm.
Và điều đáng quan tâm không phải chỉ là:
Component này còn khỏe không?
Mà là:
Cả execution path hiện còn khả năng hoàn thành thêm bao nhiêu công việc một cách ổn định?
Hai câu hỏi này rất khác nhau.
Khi mỗi thành phần chỉ nhìn thấy một phần của hệ thống
Trong kiến trúc cloud-native điển hình, mỗi hệ thống con thường quan sát rất tốt phạm vi của riêng mình.
Gateway biết lượng request đang vào.
Service mesh biết traffic giữa các service.
Autoscaler nhìn CPU, memory hoặc một số metric được cấu hình.
Message broker biết queue và consumer lag.
Redis biết memory, connection và latency của Redis.
Application biết số request hay task nó đang xử lý.
Circuit breaker biết một dependency đang lỗi nhiều hay ít.
Từng thành phần đều có thông tin chính xác.
Nhưng phần lớn đó là local state — trạng thái cục bộ.
Không thành phần nào mặc nhiên biết được trạng thái hoàn chỉnh của cả một business request đang đi xuyên qua hệ thống.
Đây chính là khoảng cách giữa:
component health
và
system execution capacity.
Gateway có thể vẫn khỏe.
CPU của application vẫn thấp.
Kafka chưa đầy.
Redis chưa hết bộ nhớ.
Nhưng downstream execution pool đã kín.
Xét riêng từng thành phần, hệ thống vẫn có vẻ bình thường.
Xét theo đường thực thi, hệ thống đã bão hòa.
Khi các cơ chế bảo vệ bắt đầu tác động lẫn nhau
Một hệ thống phân tán không cần có component nào thực sự “hỏng” để trở nên mất ổn định.
Chỉ cần các cơ chế điều khiển riêng lẻ phản ứng với nhau không đúng lúc.
Ví dụ một downstream service bắt đầu chậm.
Request từ upstream vẫn tiếp tục đổ xuống.
Hàng đợi hình thành.
Một số request timeout.
Client retry.
Retry làm tải tăng.
Circuit breaker bắt đầu mở.
Traffic được đẩy sang các instance khác.
Các instance đó lại chịu tải cao hơn.
Autoscaler nhìn thấy CPU tăng và bắt đầu tạo thêm replica.
Nhưng replica mới chưa sẵn sàng ngay.
Trong lúc đó backlog vẫn tiếp tục tích tụ.
Thậm chí một request đã timeout ở phía gọi nhưng phía dưới vẫn đang xử lý. Khi client retry, cùng một công việc có thể được thực hiện thêm lần nữa.
Không nhất thiết có component nào bị lỗi.
Mỗi component có thể đang làm đúng nhiệm vụ của mình.
Nhưng toàn hệ thống vẫn gặp sự cố.
Đó là một đặc điểm quan trọng của distributed systems: nhiều sự cố sinh ra từ interaction giữa các subsystem, chứ không phải từ lỗi của một subsystem cụ thể.
Càng nhiều control plane độc lập, số quan hệ phải hiểu và kiểm soát càng lớn.
Backpressure không đơn giản là rate limiting
Một số khái niệm thường được đặt gần nhau nhưng thực tế giải quyết các câu hỏi khác nhau.
Rate limiting hỏi:
Có nên cho request này đi qua không?
Autoscaling hỏi:
Có cần tăng thêm tài nguyên hay instance không?
Circuit breaker hỏi:
Dependency này có đủ khỏe để tiếp tục gọi không?
Bulkhead giới hạn số lượng execution đồng thời trong một vùng nhất định.
Còn admission control ở cấp runtime phải trả lời một câu hỏi sâu hơn:
Hệ thống hiện còn đủ khả năng thực thi để nhận thêm công việc hay không?
Đây không chỉ là vấn đề traffic.
Một hệ thống có thể nhận được 100.000 request nhưng chỉ có khả năng xử lý ổn định 10.000 execution đồng thời.
Nếu nhận tất cả rồi mới đưa phần dư vào queue, hệ thống đã chuyển từ ngăn quá tải sang quản lý hậu quả của quá tải.
Khác biệt nằm ở thời điểm đưa ra quyết định.
Một mô hình chủ động có thể hình dung như:
biết capacity → nhận work → thực thi → truyền áp lực ngược lên upstream
Thay vì:
nhận tất cả → queue → timeout → retry → circuit break → scale → phục hồi
Cả hai có thể dùng nhiều công nghệ giống nhau.
Nhưng cách kiểm soát hệ thống khác nhau về bản chất.
Chi phí vận hành không chỉ nằm ở số máy chủ
Khi nói về độ phức tạp của cloud-native, người ta thường nhắc đến YAML, Helm chart, Terraform hay số lượng container.
Đó mới chỉ là phần dễ nhìn thấy.
Chi phí lớn hơn nằm ở việc phải giữ cho nhiều hệ thống độc lập cùng hoạt động đúng trong một đường thực thi chung.
Mỗi thành phần mới thường kéo theo:
- cách triển khai riêng;
- cấu hình riêng;
- cơ chế bảo mật riêng;
- monitoring và alerting riêng;
- chiến lược scale riêng;
- quy trình backup và recovery;
- compatibility giữa các version;
- quy trình nâng cấp;
- cách xử lý lỗi riêng;
- kiến thức chuyên môn riêng.
Vì vậy chi phí vận hành không tăng chỉ vì có thêm một container.
Nó tăng vì có thêm một ranh giới phải vận hành và phối hợp độc lập.
Sử dụng managed Kafka, managed Kubernetes hay hosted observability chắc chắn có thể giảm khối lượng công việc hạ tầng.
Nhưng chúng không làm biến mất các mối quan hệ trong kiến trúc.
Application vẫn phải hiểu broker.
Retry vẫn phải được cấu hình đúng.
Timeout giữa các lớp vẫn phải tương thích.
Schema vẫn phải quản lý.
Identity và authorization vẫn phải đi xuyên qua nhiều hệ thống.
Khi có incident, đội vận hành vẫn phải lần theo request qua nhiều nơi để tìm nguyên nhân.
Managed service chuyển bớt việc vận hành một sản phẩm sang nhà cung cấp.
Nó không xóa được coordination cost — chi phí phối hợp giữa các thành phần.
Technical debt thường tích tụ ở những đường nối
Technical debt thường được hiểu là code cũ, code khó bảo trì hay những quyết định tạm thời trong business logic.
Trong hệ thống phân tán, một loại nợ kỹ thuật khác khó nhìn thấy hơn nằm ở chính những điểm nối giữa các thành phần.
Gateway phải biết cách chuyển request vào service.
Service phải biết cách gọi RPC.
RPC phải tương tác với messaging.
Messaging phải được ánh xạ vào worker.
Worker phải sử dụng cache.
Telemetry từ application phải đi vào hệ thống observability.
Identity phải được giữ xuyên qua toàn bộ chuỗi.
Mỗi điểm nối tạo ra thêm một hợp đồng kỹ thuật:
- cấu trúc dữ liệu;
- serialization;
- authorization;
- retry;
- timeout;
- error mapping;
- tracing;
- version;
- naming;
- routing;
- compatibility.
Ban đầu những thứ này thường rất nhỏ.
Một adapter ở đây.
Một interceptor ở kia.
Một custom header.
Một quy ước về correlation ID.
Một wrapper cho message.
Một retry policy đặc biệt.
Một exception mapping riêng.
Nhưng sau vài năm, hàng trăm giả định nhỏ này bắt đầu ràng buộc hệ thống.
Đây chính là integration debt — nợ kỹ thuật phát sinh từ việc tích hợp.
Nó đặc biệt khó phát hiện vì thường không nằm trọn trong repository của một team nào.
Nó nằm giữa các team, giữa các service và giữa các tầng hạ tầng.
AI không tạo ra vấn đề này, AI chỉ khiến nó dễ nhìn thấy hơn
Sự xuất hiện của AI agent và Model Context Protocol — MCP — là một ví dụ rất rõ.
Giả sử doanh nghiệp đã có hàng trăm API hoặc RPC.
Thoạt nhìn, việc biến chúng thành công cụ cho AI có vẻ đơn giản:
thêm một MCP Gateway.
Nhưng gateway đó vẫn cần biết:
- công cụ nào tồn tại;
- input và output là gì;
- ai được phép gọi;
- context được truyền như thế nào;
- lỗi được trả về ra sao;
- pagination hoạt động thế nào;
- resource được biểu diễn thế nào;
- quota được áp dụng ra sao;
- monitoring nằm ở đâu;
- overload được kiểm soát thế nào.
Nếu các capability này vốn đã nằm rải rác ở nhiều nơi, MCP trở thành một lớp tích hợp mới.
Thêm một adapter.
Thêm một boundary.
Thêm một nơi phải dịch và giữ semantics nhất quán.
AI không tạo ra fragmentation.
Nó chỉ làm fragmentation đã tồn tại trở nên rõ hơn.
Nếu ngược lại, RPC, routing, authorization, execution và admission đã nằm trong cùng một runtime model, MCP có thể chỉ là một giao thức mới để expose những capability mà runtime vốn đã hiểu.
Một bên phải bọc lại capability hiện có.
Một bên chỉ cần mở capability hiện có ra một giao diện mới.
Khác biệt này rất lớn khi hệ thống có hàng trăm hoặc hàng nghìn operation.
Nhìn VIEApps NGX từ góc độ execution
Nếu chỉ so sánh theo feature, rất dễ tạo ra một bảng kiểu:
Gateway so với Kong.
Routing so với Istio.
RPC so với gRPC.
Messaging so với Kafka.
Caching so với Redis.
Observability so với OpenTelemetry.
MCP so với AI Gateway.
Nhưng cách so sánh đó bỏ qua câu hỏi quan trọng nhất.
VIEApps NGX không cần phải thắng từng công cụ chuyên dụng trong benchmark riêng lẻ.
Kafka có thể mạnh hơn trong một số workload messaging chuyên biệt.
Envoy có thể cực kỳ tốt ở proxying.
Redis có thể vượt trội ở một số dạng distributed data.
Đó là điều bình thường.
Câu hỏi quan trọng hơn là:
Các capability đó có cùng nằm trong một execution model hay không?
VIEApps NGX lựa chọn đưa communication, Routed RPC, messaging, routing, execution coordination, admission, telemetry hooks và MCP exposure vào cùng một runtime foundation.
Điều đó không làm hạ tầng biến mất.
Database vẫn tồn tại.
Cache vẫn tồn tại.
Message storage vẫn có thể cần.
Logging backend vẫn cần.
Network vẫn có thể lỗi.
Khác biệt là những thành phần đó không phải tự ghép lại để tạo nên execution semantics của toàn hệ thống.
Runtime chịu trách nhiệm cho phần này.
Có thể tóm lại bằng một câu:
Cloud-native composes infrastructure. VIEApps NGX unifies execution.
Cloud-native ghép các thành phần hạ tầng.
VIEApps NGX cố gắng thống nhất cách công việc được giao tiếp, định tuyến và thực thi.
Một runtime không làm complexity biến mất
Không có kiến trúc nào xóa được độ phức tạp vốn có của distributed systems.
Network vẫn có thể lỗi.
Database vẫn có thể nghẽn.
Cache vẫn có vấn đề invalidation.
Partition vẫn có thể nóng.
Dependency bên ngoài vẫn có thể chậm.
Sự khác biệt nằm ở việc complexity được đặt ở đâu.
Nếu complexity được phân tán qua nhiều subsystem, tổ chức phải liên tục giữ cho nhiều trạng thái độc lập phù hợp với nhau.
Nếu một phần complexity được runtime hấp thụ, application team phải tự quản lý ít trạng thái và ít mối nối hơn.
Đến đây, hiệu năng, độ ổn định, chi phí vận hành và technical debt thực ra không còn là bốn câu chuyện riêng biệt.
Chúng là bốn biểu hiện của cùng một vấn đề:
execution fragmentation.
Hiệu năng giảm khi bottleneck xuất hiện trên các đường nối.
Độ ổn định giảm khi nhiều control loop tác động lẫn nhau.
Chi phí vận hành tăng khi số boundary phải duy trì tăng.
Technical debt tăng khi contract và assumption tích tụ tại các điểm nối.
Tích hợp AI trở nên đắt đỏ khi phải bổ sung thêm một lớp chuyển đổi trên một execution model vốn đã phân mảnh.
Vì vậy, thay vì chỉ hỏi một hệ thống có bao nhiêu service, container hay technology stack, có lẽ một câu hỏi hữu ích hơn là:
Để một business request hoàn thành, có bao nhiêu execution state độc lập phải được giữ nhất quán với nhau?
Đó có thể là một cách thực tế hơn để nhìn vào độ phức tạp của kiến trúc.
Bởi cuối cùng, người dùng không sử dụng từng component.
Họ sử dụng một execution path.